

Содержание
- 1. Как работает индексация в Яндексе и сколько времени она занимает
- 2. Как проверить, проиндексирована ли страница в Яндексе
- 3. Почему новые страницы не попадают в индекс Яндекса: основные причины
- 4. Как robots.txt, noindex, canonical и коды ответа сервера блокируют индексацию
- Файл robots.txt
- Мета-тег noindex и HTTP-заголовки
- Canonical
- Коды ответа сервера
- 5. Что значит статус «Малоценная или маловостребованная страница» и как его исправить
- 6. Почему Яндекс исключает дубли и неканонические страницы из поиска
- 7. Как краулинговый бюджет и внутренняя перелинковка влияют на скорость индексации
- 8. Как ускорить индексацию новых страниц через Яндекс Вебмастер, Sitemap и IndexNow
- Переобход в Яндекс Вебмастере
- Карта сайта Sitemap
- IndexNow
- Дополнительные сигналы
- 9. Как проверить ограничения и проблемы с качеством сайта в Яндексе
- 10. Что делать, если страница доступна Яндексу, но её нет в поиске
- 11. FAQ
- 12. Заключение
Вы опубликовали новую статью или карточку товара, прошла неделя, а в выдаче её всё нет. Знакомая ситуация для любого владельца сайта. Яндекс не обязан индексировать каждую страницу сайта, которую видит, и причин отказа бывает много: от одной строчки в robots.txt до низкого качества контента.
В этой статье разбираем, как работает индексация в Яндексе, как проверить статус конкретной страницы, почему новые страницы не попадают в индекс и что делать, чтобы это исправить. Важная оговорка сразу: ни один инструмент не гарантирует попадание документа в поиск, он лишь помогает роботу её найти. Решение об индексировании поисковая система принимает сама.
Как работает индексация в Яндексе и сколько времени она занимает
Чтобы правильно искать причину, по которой не идёт индексация, полезно разделить путь страницы на четыре этапа. Их часто смешивают, хотя это разные процессы.
- Обнаружение. Поисковая система узнаёт о новом URL: из карты сайта, внутренних и внешних ссылок, данных Метрики, ручной отправки на переобход или уведомления по протоколу IndexNow.
- Обход. Робот Яндекса запрашивает URL и получает ответ сервера. Код ответа определяет дальнейший сценарий: при 200 робот получает доступ к документу, при 301 или 302 проверяет целевой адрес редиректа, при 304 понимает, что содержимое не изменилось с прошлого визита, а при ошибке сервера может повторить запрос позже. Если обход запрещён правилами сайта, робот документ не скачивает.
- Индексирование. Система оценивает контент, ищет дубли, определяет каноническую версию и решает, включать ли документ в поисковую базу. Код 200 — обязательное условие, но не гарантия: доступная страница всё равно может быть исключена.
- Ранжирование. Это уже отдельный вопрос: страница может быть в индексе, но не показываться высоко по нужному запросу.
Сколько времени занимает индексация? Универсального срока нет. В справке Яндекса ориентир — около двух недель после того, как робот обошёл сайт, но на практике сроки сильно отличаются для разных сайтов и даже для разных страниц одного сайта. Поэтому прошедшие дни сами по себе не доказывают ошибку. Надёжнее отслеживать статус в панели Яндекса.
На обнаружение и обход, а значит и на индексацию новых страниц, прямо влияют:
- внутренние ссылки с уже проиндексированных разделов сайта;
- наличие адреса в актуальной карте сайта;
- данные Метрики, если счётчик связан с сайтом в Вебмастере;
- доступность и стабильность сервера;
- настройка скорости обхода в панели.
Отдельно о новом сайте. У молодого сайта роботу известно мало адресов, внутренняя перелинковка ещё не выстроена, внешних упоминаний почти нет — поэтому найти страницы сложнее. Это не особый «режим проверки», а просто недостаток сигналов. Что делать: добавить сайт в Яндекс Вебмастер, отправить карту сайта, связать новые материалы внутренними ссылками и убедиться, что сайт отдаёт корректный код ответа.
Как проверить, проиндексирована ли страница в Яндексе
Самый точный способ — Яндекс Вебмастер. В нём есть три инструмента, которые стоит знать каждому владельцу сайта.
- Проверка статуса URL. В разделе «Индексирование» вставьте адрес и нажмите «Проверить». Инструмент покажет, есть ли страница в поиске, дату последнего обхода, код ответа сервера и причину исключения, если она не попала в индекс. Это самый быстрый способ понять, что происходит с конкретной страницей.

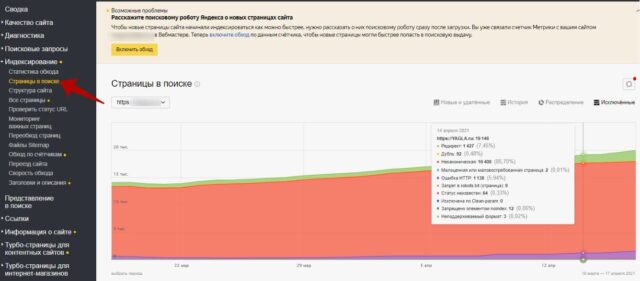
- Отчёт «Страницы в поиске». Он показывает, какие документы сайта добавлены в поиск и какие исключены. На вкладке «Исключённые» видно статус каждой: «Дубль», «Неканоническая», «Малоценная или маловостребованная», «Запрещено в robots.txt», «Редирект», «Ошибка HTTP». Расшифровка каждого статуса есть в разделе справки об исключённых страницах.
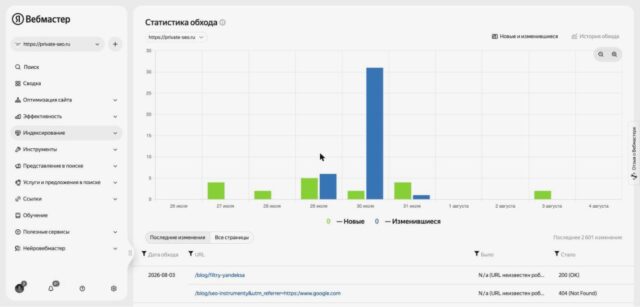
- Статистика обхода. Здесь видно, какие URL запрашивались, когда и какой ответ был получен. Если новой страницы в списке нет, робот до неё просто не доходит, и искать причину нужно на этапе обнаружения: в структуре, ссылках и карте.
Быстрая проверка без Вебмастера — операторы поиска. Запрос url:site.ru/page/ покажет, есть ли адрес в индексе, а site:site.ru — примерное количество документов сайта в индексе. Но данные операторов приблизительные, поэтому для диагностики опирайтесь на отчёты Вебмастера. Полезная привычка — проверять индексацию важных материалов через какое-то время после публикации.
Почему новые страницы не попадают в индекс Яндекса: основные причины
Если коротко, страница не попадает в индекс из-за одной из четырёх групп причин — по этапам, описанным выше:
- Её не обнаружили. На неё нет внутренних ссылок, её нет в карте сайта, она не отправлена на переобход. Такой «сиротский» документ поисковик может не находить долго.
- Её нашли, но не смогли обойти. Адрес закрыт в robots.txt, сервер отвечает ошибкой, вместо документа стоит редирект, важный текст может быть недоступен роботу, если JavaScript не отработал корректно или содержимое не попало в обработанную версию страницы.
- Её обошли, но не включили в индекс. Стоит мета-тег noindex, страница дублирует другую, canonical указывает на другой адрес, у документа нет самостоятельной ценности для пользователя.
- Есть нарушения на уровне всего сайта. Поисковый спам, угрозы безопасности и другие проблемы, о которых Вебмастер сообщает в диагностике.
Самая частая проблема у новых сайтов — первая группа: ссылок мало, карта не настроена. У интернет-магазинов чаще встречаются вторая и третья: дубли карточек товаров, страницы фильтров, пустые категории. Поэтому диагностику проблем с индексацией стоит начинать с проверки статуса URL — отчёт сразу покажет, на каком этапе застряла страница.
Отдельный случай — когда новый сайт вообще не индексируется. Обычно причина одна из трёх: сайт закрыт от поисковых систем целиком, поисковик ещё не знает о домене или главная отдаёт ошибку. Проверьте её через инструмент проверки статуса URL — он сразу покажет, видит ли её поисковик.
Как robots.txt, noindex, canonical и коды ответа сервера блокируют индексацию
Это технические причины, и их проще всего исправить. Но одна ошибка в шаблоне может закрыть от индексации сразу тысячи страниц, поэтому после каждого обновления движка сайта или темы такие настройки стоит перепроверять.
Файл robots.txt
Файл robots.txt говорит краулеру, какие разделы сайта можно обходить. Типичная ошибка — слишком широкое правило. Например, Disallow: /catalog закрывает не только служебный путь, но и весь раздел каталога вместе с карточками. Другой частый случай: после переноса с тестовой версии в robots.txt остаётся Disallow: /, и сайт целиком закрыт для поиска.
Что проверить:
- откройте site.ru/robots.txt и убедитесь, что файл доступен и отдаёт код 200;
- проверьте правила через инструмент «Анализ robots.txt» в Яндекс Вебмастере — туда можно вставить список URL и увидеть, разрешены ли они;
- убедитесь, что в файле указан путь к карте сайта через директиву Sitemap;
- для параметров, которые не меняют содержимое страницы, можно использовать Clean-param; не применяйте её без проверки к параметрам фильтрации, выбора товара или сортировки, если они меняют содержание страницы — её понимает только Яндекс, и она убирает дубли без запрета нужных разделов сайта.
Учтите: директиву Crawl-delay Яндекс не учитывает, скорость обхода настраивается в панели. Директива Host тоже устарела — главное зеркало определяется по 301-редиректу.
Мета-тег noindex и HTTP-заголовки
Мета-тег <meta name="robots" content="noindex"> в коде запрещает индексировать страницу. Он часто остаётся после разработки или включается автоматически: в CMS есть настройка «скрыть от поисковых систем», а SEO-плагин может ставить noindex для целого типа записей. Так же работает HTTP-заголовок X-Robots-Tag — его не видно в исходном коде, поэтому проверяйте ответ сервера целиком.
Не путайте задачи инструментов: robots.txt управляет обходом, а мета-тег noindex — индексированием. Если адрес закрыт в этом файле, робот не скачает документ и не увидит в нём мета-тег. Поэтому для страниц с noindex обход должен быть разрешён.
Canonical
Атрибут rel=»canonical» указывает предпочтительную версию документа. Для уникальной страницы, которую вы хотите видеть в поиске, он обычно указывает на неё саму. Для дублей — например, адреса с параметрами сортировки — canonical может вести на основную версию. Ошибка возникает, когда шаблон ставит canonical на главную или на первую страницу категории для всех подряд: тогда Яндекс считает остальные неканоническими и исключает. При этом для Яндекса canonical — рекомендация, а не жёсткая команда.
Отдельно о пагинации. Не стоит автоматически ставить всем URL пагинации canonical на первую: так поисковик может хуже находить товары и статьи, которые лежат глубже. Обычно каждой странице пагинации достаточно собственного canonical.
Коды ответа сервера
Подробно реакция робота на каждый код описана в справочнике кодов HTTP. Коротко:
- 200 — документ доступен и может быть проиндексирован, но это не гарантия включения в поиск.
- 301 и 302 — редирект. Сам адрес с редиректом не индексируется, робот проверяет целевую страницу. Длинные редиректовые цепочки лишь тратят обходы впустую.
- 304 — документ не изменился с прошлой проверки, повторно скачивать его не нужно.
- 404 и 410 — документа нет, со временем он удаляется из поиска.
- 5xx и 429 — сервер не справился с запросом. Робот может прийти повторно, но регулярные ошибки мешают обходу.
Отдельная проблема — «мягкий 404», когда пустая страница отдаёт код 200. Поисковик видит такие документы, но считает их малоценными. Проверить ответ сервера можно в инструменте «Проверка ответа сервера»: он показывает код ответа, заголовки и HTML-код, который получает краулер.
Что значит статус «Малоценная или маловостребованная страница» и как его исправить
Это одна из самых частых причин, по которым индексация не приводит к показам. Статус означает, что Яндекс знает о странице, но решил не показывать её пользователям: по оценке алгоритма, у неё недостаточно ценности или на неё нет спроса.
Универсального порога по объёму текста нет. Карточка, где описание занимает менее ста слов, может быть полезной, если в ней есть характеристики, фото, цена и условия покупки. А длинная статья может оставаться бесполезной, если не отвечает на вопрос. Признаки слабой страницы обычно такие:
- нет полезной информации, которой нет у конкурентов и на других сайтах;
- контент скопирован у производителя или с других сайтов;
- документ сгенерирован автоматически по шаблону и почти не отличается от соседних;
- страница не отвечает полностью на запрос пользователя;
- по теме почти нет поисковых запросов — узкие комбинации фильтров, теги, архивы.
Это ориентиры, а не точный диагноз: прежде чем переделывать страницу, посмотрите данные панели и сравните её с теми, что уже в поиске.
Как исправить:
- Добавьте уникальный текст, который отвечает на запрос пользователя: описание, характеристики, ответы на вопросы, сравнение.
- В карточку товара добавляйте отзывы, фото, таблицу параметров, информацию о доставке и оплате.
- Объединяйте похожие узкие страницы в одну полноценную или закрывайте от индексации те, у которых нет спроса.
- Проверьте частотность запроса через Вордстат. Если спроса нет, такой документ вряд ли нужен в индексе.
- После доработки отправьте адрес на переобход и следите за статусом: системе нужно время, чтобы переоценить документ.
Не стоит массово переписывать сотни страниц за раз. Начните с важных — тех, что приносят трафик или должны его приносить.
Почему Яндекс исключает дубли и неканонические страницы из поиска
Поиск не хочет показывать в выдаче несколько одинаковых документов, поэтому из группы дублей оставляет один, а остальные исключает со статусом «Дубль» или «Неканоническая». Проблема в том, что выбирает он не всегда ту версию, которую вы считаете основной.
Откуда берутся дубли на сайте:
- адреса со слешем и без, с www и без, с http и https;
- GET-параметры: сортировка, UTM-метки, идентификаторы сессий;
- страницы фильтровой навигации с одинаковым содержимым;
- один товар в нескольких категориях с разными URL;
- версии для печати и старые адреса, которые продолжают открываться после смены структуры сайта.
Как устранять:
- настройте 301-редиректы на одну версию адреса: протокол, www, слеш;
- укажите корректный canonical там, где есть дубли;
- добавьте Clean-param в robots.txt для параметров, которые не меняют содержимое;
- для карточки товара используйте один постоянный адрес, а категории связывайте с ней ссылками;
- делайте уникальными заголовок title, мета-описание и H1.
Если страница исключена как дубль, сервис показывает, какой адрес выбран вместо неё. Это помогает быстро найти источник проблемы: часто им оказывается шаблон, который генерирует лишние URL.
Как краулинговый бюджет и внутренняя перелинковка влияют на скорость индексации
Краулинговый бюджет — условное название для объёма страниц, который робот обходит на сайте за определённое время. На индексацию он заметно влияет только у крупных проектов: для небольшого сайта на 100–200 URL он почти никогда не становится ограничением.
На сайте интернет-магазина с десятками тысяч URL картина другая: робот может тратить обходы на фильтры, сортировки, дубли и редиректы. Чтобы понять, так ли это у вас, сравните список URL из карты сайта с адресами, которые робот фактически запрашивает в отчёте «Статистика обхода». Если там много лишнего, выясните, откуда они берутся: из ссылок в шаблоне, параметров, старой структуры или внешних источников.
Что помогает обходу:
- закройте от обхода служебные разделы, корзину, внутренний поиск, бесконечные комбинации фильтров — Яндекс отдельно описывает это в справке о страницах, не нужных в поиске;
- уберите редиректы из внутренних ссылок — ссылайтесь сразу на конечный адрес;
- исправьте битые ссылки и ошибки 5xx;
- следите за временем ответа сервера: если он регулярно отвечает по несколько секунд или с ошибками, обход становится менее эффективным.
Внутренняя перелинковка — один из главных способов показать роботу новые страницы. Документ, на который ведут ссылки с главной, из меню или популярных статей, проще обнаружить, чем материал на пятом уровне вложенности.
Что помогает:
- чёткая структура сайта: до важной страницы — несколько кликов от главной;
- хлебные крошки во всех разделах;
- блоки «Новинки», «Похожие товары», «Читайте также»;
- ссылки на новую статью из старых материалов по теме;
- обычные HTML-ссылки вместо JavaScript-переходов, которые робот может не распознать.
Как ускорить индексацию новых страниц через Яндекс Вебмастер, Sitemap и IndexNow
Точнее сказать — как быстрее сообщить Яндексу о новых страницах. Все инструменты ниже улучшают обнаружение, но решение об индексации остаётся за поисковой системой.
Переобход в Яндекс Вебмастере
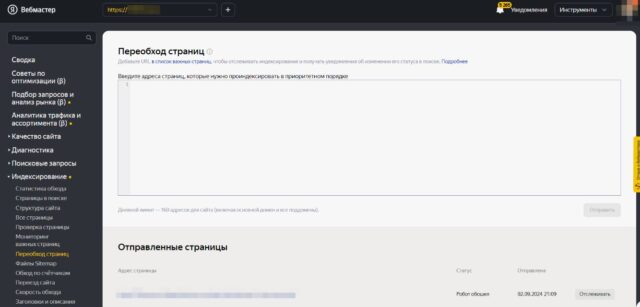
В разделе «Индексирование» → «Переобход страниц» можно отправить конкретные URL. Есть дневной лимит, который зависит от сайта. Отправляйте в первую очередь новые и обновлённые важные страницы. Это сигнал роботу прийти, а не гарантия: если со страницей есть проблемы, переобход не поможет.
Карта сайта Sitemap
XML-карта перечисляет все адреса, которые вы хотите видеть в поиске. Это базовый инструмент для индексации сайта. Правила:
- включайте только страницы с кодом 200, без редиректов, дублей и закрытых адресов;
- указывайте дату изменения в lastmod — реальную, а не текущую для всех записей;
- не более 50 000 URL и 50 МБ в одном файле, для больших сайтов используйте индексный файл карт;
- карта должна обновляться автоматически при добавлении новой страницы;
- добавьте её в Вебмастер в разделе «Файлы Sitemap» и пропишите в robots.txt.
IndexNow
Протокол IndexNow позволяет самому уведомлять поисковые системы о новых, изменённых и удалённых URL. Яндекс его поддерживает. Чтобы подключить:
- сгенерируйте ключ и разместите текстовый файл с ним в корне сайта;
- настройте отправку запросов при публикации или изменении материала — через API или с помощью плагина для вашей CMS;
- проверьте в Вебмастере, что уведомления принимаются без ошибок.
IndexNow удобен для массовой отправки, но это тоже уведомление, а не команда проиндексировать.
Дополнительные сигналы
- Установите Яндекс Метрику, свяжите счётчик с сайтом и включите в Вебмастере обход по счётчикам — так поисковик сможет узнавать о посещаемых разделах сайта.
- Ссылки на новые материалы в социальных сетях и на тематических площадках могут помочь обнаружению, но индексацию не гарантируют.
Как проверить ограничения и проблемы с качеством сайта в Яндексе
Иногда проблема не в отдельной странице, а в сайте целиком. Главный источник информации здесь — уведомления Вебмастера, а не догадки по косвенным признакам.
Где смотреть: в Вебмастере откройте «Оптимизация сайта» → «Безопасность и нарушения».
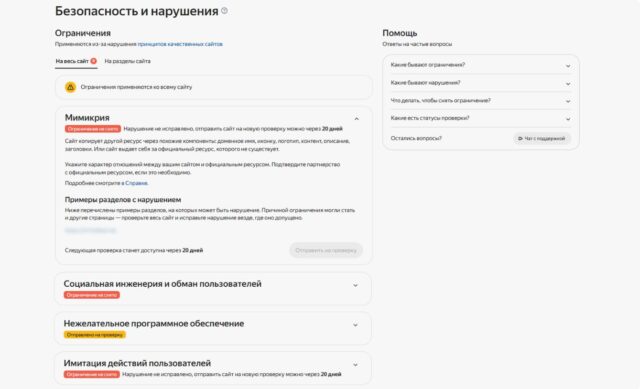
Если Яндекс обнаружил нарушение на сайте, там будет сообщение с описанием причины. Чаще всего это:
- угрозы безопасности — вредоносный код, фишинг, последствия взлома;
- поисковый спам — дорвеи, сгенерированные страницы, тексты, переполненные ключевыми словами;
- манипуляции — попытки искусственно повлиять на выдачу.
Устраните нарушение и сообщите об этом через кнопку в том же разделе. Сколько займёт повторная проверка, заранее сказать нельзя.
В SEO-среде до сих пор в ходу названия вроде АГС, «Баден-Баден» или «Минусинск». Но ставить такой «диагноз» только по падению числа страниц в индексе не стоит: тот же результат дают технические ошибки, смена шаблона, массовые дубли или неудачный переезд. Если уведомлений нет, а индексация резко просела, начните с технического аудита: проверьте коды ответа, robots.txt, canonical, noindex, затем оцените качество контента.
Что делать, если страница доступна Яндексу, но её нет в поиске
Частая проблема с индексацией: проверка показывает, что робот загрузил страницу и получил код 200, но в выдаче её нет. Возможные причины:
- Поисковая база ещё не обновилась. Между обходом и появлением в поиске проходит время. Следите за статусом в Вебмастере.
- Документ исключён как малоценный или дубль. Проверьте статус в отчёте «Страницы в поиске» на вкладке «Исключённые».
- Страница в индексе, но не ранжируется. Её нет в топе по нужному запросу, хотя по оператору url: она находится. Это уже вопрос продвижения, а не индексации.
- Контент не виден поисковику. Текст подгружается JavaScript, и в исходном HTML страница пустая. Сравните исходный код с тем, что видит пользователь.
Пошаговый чек-лист диагностики:
- Проверьте статус в Вебмастере и дату последнего обхода.
- Убедитесь, что код ответа 200, нет noindex и запрета в robots.txt.
- Проверьте canonical: он должен указывать на ту версию, которую вы хотите видеть в поиске.
- Посмотрите, нет ли дублей с похожим содержимым.
- Оцените контент: есть ли уникальный текст, отвечает ли страница на запрос.
- Убедитесь, что на неё ведут внутренние ссылки и она есть в карте.
- Отправьте её на переобход или через IndexNow.
- Отслеживайте изменение статуса, а не считайте дни.
Если таких страниц на сайте много, проблема с индексацией скорее системная: ищите общую причину в шаблоне.
FAQ
Сколько страниц можно отправить на переобход в день?
Лимит индивидуален для каждого сайта и указан в инструменте «Переобход страниц». Для массовых уведомлений удобнее IndexNow и актуальная карта.
Почему страница выпала из индекса, хотя раньше была в поиске?
Частые причины — смена шаблона с ошибкой в canonical или правилах обхода, появление дублей, снижение востребованности, ошибки сервера. Проверьте статус: Вебмастер покажет причину исключения.
Индексирует ли Яндекс сайты на JavaScript?
Робот умеет обрабатывать JavaScript, но не всегда делает это полностью и быстро. Для индексации надёжнее, когда основной текст, заголовки и ссылки есть в исходном HTML — с помощью серверного рендеринга или пререндера.
Как удалить ненужную страницу из индекса?
Если страницы больше нет, отдайте код 404 или 410. Если она должна остаться доступной пользователям, но не показываться в поиске, поставьте noindex и не закрывайте её от обхода — иначе робот не увидит мета-тег. Ускорить процесс поможет инструмент «Удаление страниц из поиска» в Вебмастере. Подробности — в справке Яндекса.
Нужно ли закрывать от индексации страницы пагинации?
Обычно нет: через них робот находит товары и статьи. Не ставьте всем canonical на первую страницу — достаточно собственного canonical и уникального title.
Сколько ждать после отправки на переобход?
Точного срока нет. Яндекс в справке называет ориентир около двух недель после обхода, но для конкретной страницы всё индивидуально. Главное — отслеживать статус в Вебмастере, а не ждать фиксированную дату.
Заключение
Проблемы с индексацией почти всегда решаются системным подходом. Сначала проверьте статус в Яндекс Вебмастере и найдите этап, на котором страница застряла: обнаружение, обход, индексирование или ранжирование. Затем устраните технические ошибки в robots.txt, мета-тегах, canonical и кодах ответа.
После этого займитесь качеством контента и дублями, выстройте внутреннюю перелинковку и сообщайте о новых страницах через переобход, карту и IndexNow. Регулярно проверяйте индексацию сайта в Вебмастере, чтобы замечать проблемы раньше, чем просядет трафик.